1. 数据类型#
1.1 引用类型vs基础类型#
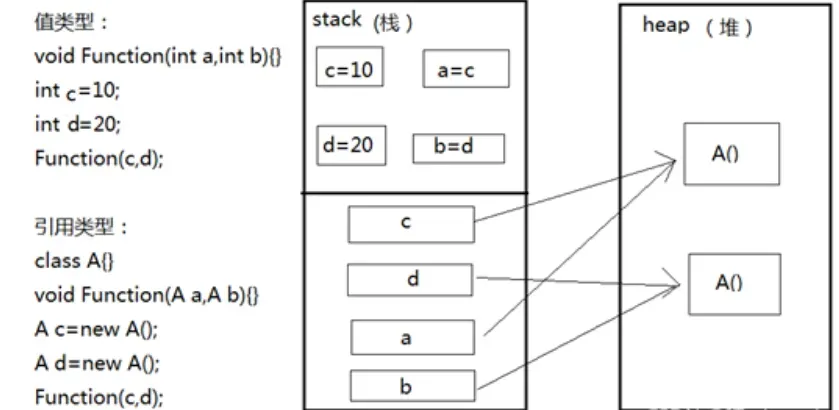
Java中的数据类型可以分为两类:基本类型和引用类型。基本类型包括:整型(byte,short,int,long)、浮点型(float,double)、字符型(char)、布尔型(boolean)。引用类型是指除了基本的变量类型之外的所有类型(如通过 class 定义的类型)。 基本类型只有一块存储空间(分配在stack中),而引用类型有两块存储空间(一块在stack中,一块中heap中)
1.2 Integer相比int有什么优点#
- 基本类型和引用类型:int是一种基本数据类型,而Integer是一种引用类型。基本数据类型是预定义的,不需要实例化就可以使用。而引用类型则需要通过实例化对象来使用,必须为对象分配内存。在性能方面,基本数据类型的操作通常比相应的引用类型快。
- 自动装箱和拆箱:Integer可以实现自动装箱和拆箱。
- 空指针异常:如果对一个未经初始化的Integer变量进行操作,就会出现空指针异常。这是因为它被赋予了null值,而null值是无法进行自动拆箱的。
- 一个Integer对象占用16个字节的存储空间,而一个int类型数据只占用4字节存储空间
1.3 integer的缓存#
Java的Integer类内部实现了一个静态缓存池,用于存储特定范围内的整数值对应的Integer对象。 默认情况下,这个范围是-128至127。当通过Integer.valueOf(int)方法创建一个在这个范围内的整数对象时,并不会每次都生成新的对象实例,而是复用缓存中的现有对象,会直接从内存中取出,不需要新建一个对象。
2. Object#
2.1 == 和 equals#
== 对于基本类型和引用类型的作用效果是不同的:
- 对于基本数据类型来说,
==比较的是值。 - 对于引用数据类型来说,
==比较的是对象的内存地址。
equals() 不能用于判断基本数据类型的变量,只能用来判断两个对象是否相等。equals()方法存在于Object类中,而Object类是所有类的直接或间接父类,因此所有的类都有equals()方法。
Object 类 equals() 方法:
public boolean equals(Object obj) {
     return (this == obj);
}equals() 方法存在两种使用情况:
- 类没有重写 equals()方法:通过equals()比较该类的两个对象时,等价于通过
==比较这两个对象,使用的默认是 Object类equals()方法。 - 类重写了 equals()方法:一般我们都重写equals()方法来比较两个对象中的属性是否相等(例如String);若它们的属性相等,则返回 true(即,认为这两个对象相等)。
举个例子:
String a = new String("ab"); // a 为一个引用
String b = new String("ab"); // b为另一个引用,对象的内容一样
String aa = "ab"; // 放在常量池中
String bb = "ab"; // 从常量池中查找
System.out.println(aa == bb);// true
System.out.println(a == b);// false
System.out.println(a.equals(b));// true
System.out.println(42 == 42.0);// trueString 中的 equals 方法是被重写过的,因为 Object 的 equals 方法是比较的对象的内存地址,而 String 的 equals 方法比较的是对象的值。 当创建 String 类型的对象时,虚拟机会在常量池中查找有没有已经存在的值和要创建的值相同的对象,如果有就把它赋给当前引用。如果没有就在常量池中重新创建一个 String 对象。
2.2 hashCode()#
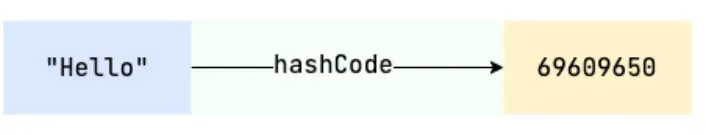
hashCode主要用于获取哈希码(int 整数),也称为散列码。这个哈希码的作用是确定该对象在哈希表中的索引位置。
当你把对象加入
HashSet时,HashSet会先计算对象的hashCode值来判断对象加入的位置,同时也会与其他已经加入的对象的hashCode值作比较,如果没有相符的hashCode,HashSet会假设对象没有重复出现。但是如果发现有相同hashCode值的对象,这时会调用equals()方法来检查hashCode相等的对象是否真的相同。如果两者相同,HashSet就不会让其加入操作成功。如果不同的话,就会重新散列到其他位置。这样我们就大大减少了equals的次数,相应就大大提高了执行速度。
其实, hashCode() 和 equals()都是用于比较两个对象是否相等。
那为什么 JDK 还要同时提供这两个方法呢?
这是因为在一些容器(比如 HashMap、HashSet)中,有了 hashCode() 之后,判断元素是否在对应容器中的效率会更高(参考添加元素进HashSet的过程)!
我们在前面也提到了添加元素进HashSet的过程,如果 HashSet 在对比的时候,同样的 hashCode 有多个对象,它会继续使用 equals() 来判断是否真的相同。也就是说 hashCode 帮助我们大大缩小了查找成本。
那为什么不只提供 hashCode() 方法呢?
这是因为两个对象的hashCode 值相等并不代表两个对象就相等。
那为什么两个对象有相同的 hashCode 值,它们也不一定是相等的?
因为 hashCode() 所使用的哈希算法也许刚好会让多个对象传回相同的哈希值。越糟糕的哈希算法越容易碰撞,但这也与数据值域分布的特性有关(所谓哈希碰撞也就是指的是不同的对象得到相同的 hashCode )。
总结下来就是:
- 如果两个对象的
hashCode值相等,那这两个对象不一定相等(哈希碰撞)。 - 如果两个对象的
hashCode值相等并且equals()方法也返回true,我们才认为这两个对象相等。 - 如果两个对象的
hashCode值不相等,我们就可以直接认为这两个对象不相等。
2.3 为什么重写 equals() 时必须重写 hashCode() 方法?#
因为两个相等的对象的 hashCode 值必须是相等。也就是说如果 equals 方法判断两个对象是相等的,那这两个对象的 hashCode 值也要相等。
如果重写 equals() 时没有重写 hashCode() 方法的话就可能会导致 equals 方法判断是相等的两个对象,hashCode 值却不相等。
思考:重写 equals() 时没有重写 hashCode() 方法的话,使用 HashMap 可能会出现什么问题。
总结:
equals方法判断两个对象是相等的,那这两个对象的hashCode值也要相等。- 两个对象有相同的
hashCode值,他们也不一定是相等的(哈希碰撞)。
String#
String、StringBuffer、StringBuilder的区别#
可变性:
String 是不可变的(后面会详细分析原因)。
StringBuilder 与 StringBuffer 都继承自 AbstractStringBuilder 类,在 AbstractStringBuilder 中也是使用字符数组保存字符串,不过没有使用 final 和 private 关键字修饰,最关键的是这个 AbstractStringBuilder 类还提供了很多修改字符串的方法比如 append 方法。
abstract class AbstractStringBuilder implements Appendable, CharSequence {
    char[] value;
    public AbstractStringBuilder append(String str) {
        if (str == null)
            return appendNull();
        int len = str.length();
        ensureCapacityInternal(count + len);
        str.getChars(0, len, value, count);
        count += len;
        return this;
    }
    //...
}线程安全性:
String 中的对象是不可变的,也就可以理解为常量,线程安全。AbstractStringBuilder 是 StringBuilder 与 StringBuffer 的公共父类,定义了一些字符串的基本操作,如 expandCapacity、append、insert、indexOf 等公共方法。StringBuffer 对方法加了同步锁或者对调用的方法加了同步锁,所以是线程安全的。StringBuilder 并没有对方法进行加同步锁,所以是非线程安全的。
性能
每次对 String 类型进行改变的时候,都会生成一个新的 String 对象,然后将指针指向新的 String 对象。StringBuffer 每次都会对 StringBuffer 对象本身进行操作,而不是生成新的对象并改变对象引用。相同情况下使用 StringBuilder 相比使用 StringBuffer 仅能获得 10%~15% 左右的性能提升,但却要冒多线程不安全的风险。
对于三者使用的总结:
- 操作少量的数据: 适用
String - 单线程操作字符串缓冲区下操作大量数据: 适用
StringBuilder - 多线程操作字符串缓冲区下操作大量数据: 适用
StringBuffer
String 为什么是不可变的#
String 类中使用 final 关键字修饰字符数组来保存字符串,所以String 对象是不可变的。
public final class String implements java.io.Serializable, Comparable<String>, CharSequence {
    private final char value[];
  //...
}纠正观点: String 类内部确实使用了
final char[] value来保存字符数组,这个 value 数组的引用不能变,但如果只是这样,数组里的内容其实仍然可以被修改(因为 final 修饰引用类型,只限制引用不变,不限制对象内容改变)。
- 修饰类:该类不能被继承。
- 修饰方法:该方法不能被子类重写。
- 修饰变量(基本数据类型):变量值不能改变。
- 修饰变量(引用类型):变量不能再指向其他对象,但引用的对象内容可以改变。
String 真正不可变有下面几点原因:
- 保存字符串的数组被
final修饰且为私有的,并且String类没有提供/暴露修改这个字符串的方法。 String类被final修饰导致其不能被继承,进而避免了子类破坏String不可变。
字符串拼接用“+” 还是 StringBuilder?#
Java 语言本身并不支持运算符重载,“+”和“+=”是专门为 String 类重载过的运算符,也是 Java 中仅有的两个重载过的运算符。
String str1 = "he";
String str2 = "llo";
String str3 = "world";
String str4 = str1 + str2 + str3;上面的代码对应的字节码如下:
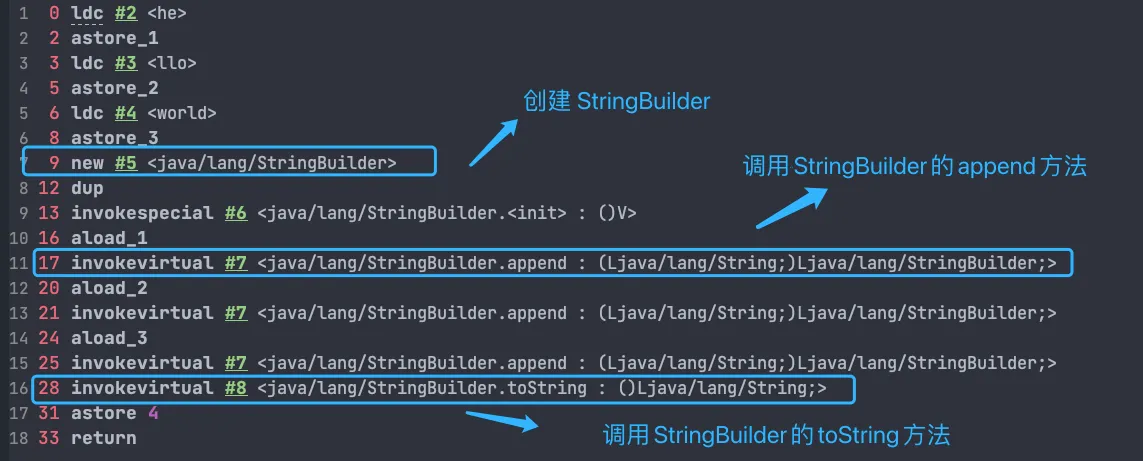
可以看出,字符串对象通过“+”的字符串拼接方式,实际上是通过 StringBuilder 调用 append() 方法实现的,拼接完成之后调用 toString() 得到一个 String 对象 。
不过,在循环内使用“+”进行字符串的拼接的话,存在比较明显的缺陷:编译器不会创建单个 StringBuilder 以复用,会导致创建过多的 StringBuilder 对象。
String[] arr = {"he", "llo", "world"};
String s = "";
for (int i = 0; i < arr.length; i++) {
    s += arr[i];
}
System.out.println(s);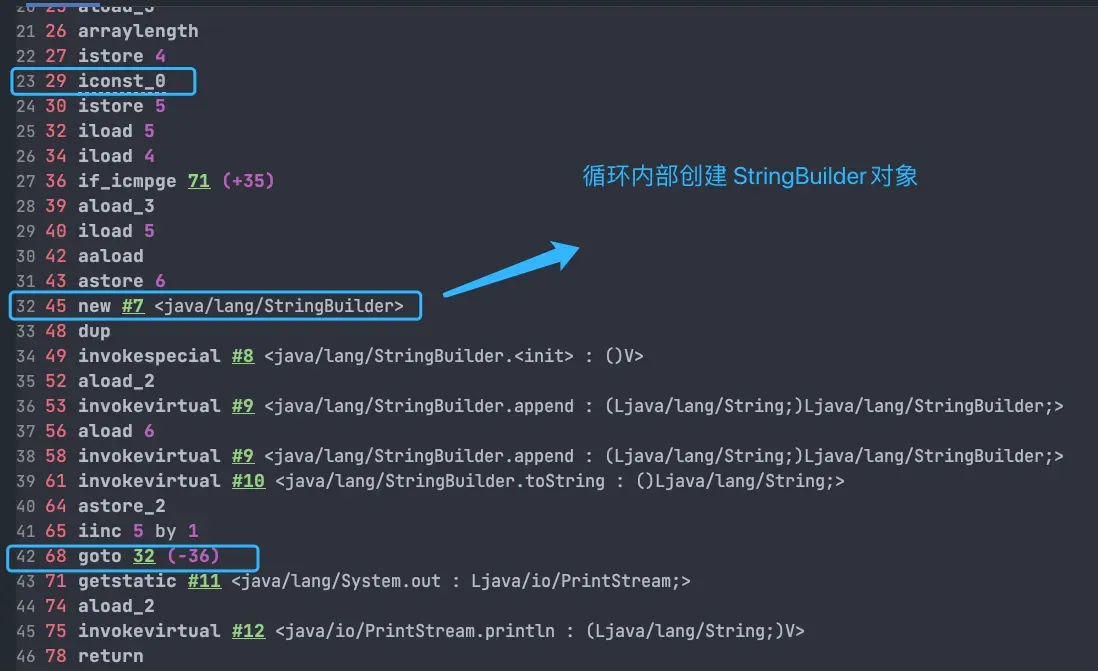
如果直接使用 StringBuilder 对象进行字符串拼接的话,就不会存在这个问题了。
String[] arr = {"he", "llo", "world"};
StringBuilder s = new StringBuilder();
for (String value : arr) {
    s.append(value);
}
System.out.println(s);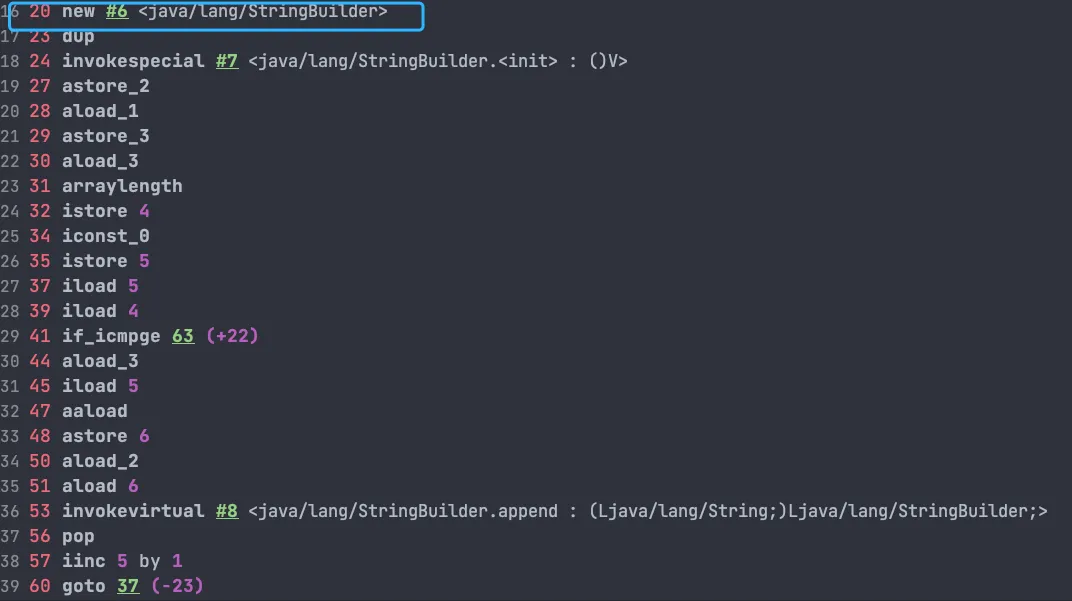
String#equals() 和 Object#equals() 有何区别?#
String 中的 equals 方法是被重写过的,比较的是 String 字符串的值是否相等。 Object 的 equals 方法是比较的对象的内存地址。
String s1 = new String(“abc”); 这句话创建了几个字符串对象?#
会创建 1 或 2 个字符串对象。
- 字符串常量池中不存在 “abc”:会创建 2 个 字符串对象。一个在字符串常量池中,由
ldc指令触发创建。一个在堆中,由new String()创建,并使用常量池中的 “abc” 进行初始化。 - 字符串常量池中已存在 “abc”:会创建 1 个 字符串对象。该对象在堆中,由
new String()创建,并使用常量池中的 “abc” 进行初始化。
String s1 = “abc”; 这句话创建了几个字符串对象?#
String s = "三妹";会创建 0 或 1 个字符串对象。
当执行 String s = "三妹" 时,Java 虚拟机会先在字符串常量池中查找有没有“abc”这个字符串对象,
- 如果有,则不创建任何对象,直接将字符串常量池中这个“三妹”的对象地址返回,赋给变量 s;
- 如果没有,在字符串常量池中创建“三妹”这个对象,然后将其地址返回,赋给变量 s。
String#intern 方法有什么作用?#
String.intern() 是一个 native (本地) 方法,用来处理字符串常量池中的字符串对象引用。它的工作流程可以概括为以下两种情况:
- 常量池中已有相同内容的字符串对象:如果字符串常量池中已经有一个与调用
intern()方法的字符串内容相同的String对象,intern()方法会直接返回该对象的引用。 - 常量池中没有相同内容的字符串对象:如果字符串常量池中还没有一个与调用
intern()方法的字符串内容相同的对象,intern()方法会将当前字符串对象的引用添加到字符串常量池中,并返回该引用。 总结:
intern()方法的主要作用是确保字符串引用在常量池中的唯一性。- 当调用
intern()时,如果常量池中已经存在相同内容的字符串,则返回常量池中已有对象的引用;否则,将该字符串添加到常量池并返回其引用。
// s1 指向字符串常量池中的 "Java" 对象
String s1 = "Java";
// s2 也指向字符串常量池中的 "Java" 对象,和 s1 是同一个对象
String s2 = s1.intern();
// 在堆中创建一个新的 "Java" 对象,s3 指向它
String s3 = new String("Java");
// s4 指向字符串常量池中的 "Java" 对象,和 s1 是同一个对象
String s4 = s3.intern();
// s1 和 s2 指向的是同一个常量池中的对象
System.out.println(s1 == s2); // true
// s3 指向堆中的对象,s4 指向常量池中的对象,所以不同
System.out.println(s3 == s4); // false
// s1 和 s4 都指向常量池中的同一个对象
System.out.println(s1 == s4); // trueString 类型的变量和常量做“+”运算时发生了什么?#
String str1 = "str";
String str2 = "ing";
String str3 = "str" + "ing";
String str4 = str1 + str2;
String str5 = "string";
System.out.println(str3 == str4);//false
System.out.println(str3 == str5);//true
System.out.println(str4 == str5);//false对于编译期可以确定值的字符串,也就是常量字符串 ,jvm 会将其存入字符串常量池。并且,字符串常量拼接得到的字符串常量在编译阶段就已经被存放字符串常量池,这个得益于编译器的优化。
对于 String str3 = "str" + "ing"; 编译器会给你优化成 String str3 = "string"; 。
并不是所有的常量都会进行折叠,只有编译器在程序编译期就可以确定值的常量才可以:
- 基本数据类型(
byte、boolean、short、char、int、float、long、double)以及字符串常量。 final修饰的基本数据类型和字符串变量- 字符串通过 “+”拼接得到的字符串、基本数据类型之间算数运算(加减乘除)、基本数据类型的位运算(<<、>>、>>> )
引用的值在程序编译期是无法确定的,编译器无法对其进行优化。
对象引用和“+”的字符串拼接方式,实际上是通过
StringBuilder调用append()方法实现的,拼接完成之后调用toString()得到一个String对象 。 str1 和 str2 是变量,虽然它们的值在这里是常量,但因为编译器无法确定变量值是否改变,它不会进行编译期拼接,而是在运行时通过StringBuilder拼接生成新的 String 对象,放在堆上,不是常量池中的引用。
String str4 = new StringBuilder().append(str1).append(str2).toString();我们在平时写代码的时候,尽量避免多个字符串对象拼接,因为这样会重新创建对象。如果需要改变字符串的话,可以使用 StringBuilder 或者 StringBuffer。
字符串使用 final 关键字声明之后,可以让编译器当做常量来处理。
示例代码:
final String str1 = "str";
final String str2 = "ing";
// 下面两个表达式其实是等价的
String c = "str" + "ing";// 常量池中的对象
String d = str1 + str2; // 常量池中的对象
System.out.println(c == d);// true被 final 关键字修饰之后的 String 会被编译器当做常量来处理,编译器在程序编译期就可以确定它的值,其效果就相当于访问常量。
如果 ,编译器在运行时才能知道其确切值的话,就无法对其优化。
示例代码(str2 在运行时才能确定其值):
final String str1 = "str";
final String str2 = getStr();
String c = "str" + "ing";// 常量池中的对象
String d = str1 + str2; // 在堆上创建的新的对象
System.out.println(c == d);// false
public static String getStr() {
      return "ing";
}3. 面向对象#
3.1 重载和重写的区别#
- 重载是指在同一个类中,可以有多个同名方法,它们具有不同的参数列表(参数类型,参数个数或参数顺序不同),编译器根据调用时的参数类型来决定调用哪个方法
- 重写指的是子类可以重新定义父类中的方法,方法名,参数列表和返回类型必须与父类中德方法一致,通过
@override注解来明确这是对父类方法的重写。
3.2 抽象类和接口的区别#
- 实现方式不同:实现接口的关键字是
implements,继承抽象类的关键字为extends。一个类可以实现多个接口,但一个类只能继承一个抽象类。 - 方法方式:接口只有定义,不能有方法的实现,java 1.8中可以定义default方法体,而抽象类可以有定义与实现,方法可在抽象类中实现。
- 访问修饰符:接口成员变量默认为
public static final,必须赋初值,不能被修改;其所有的成员方法都是public、abstract的。 抽象类中成员变量默认default,可在子类中被重新定义,也可被重新赋值;抽象方法被abstract修饰,不能被private、static、synchronized和native等修饰,必须以分号结尾,不带花括号。 - 变量:抽象类可以包含实例变量和静态变量,而接口只能包含常量(即静态常量)。
- 构造器:抽象类本身不能被实例化,但是抽象类可以有构造器,这些构造器在子类实例化时会被调用,以便进行必要的初始化工作。但是接口是绝不能有构造函数的
Java中的抽象类是用来被继承的,而final修饰符用于禁止类被继承或方法被重写,因此,抽象类和final修饰符是互斥的,不能同时使用。
3.3 非静态内部类和静态内部类的区别#
- 非静态内部类依赖于外部类的实例,而静态内部类不依赖于外部类的实例。
- 非静态内部类可以访问外部类的实例变量和方法,而静态内部类只能访问外部类的静态成员。
- 非静态内部类不能定义静态成员,而静态内部类可以定义静态成员。
- 非静态内部类在外部类实例化后才能实例化,而静态内部类可以独立实例化。
- 非静态内部类可以访问外部类的私有成员,而静态内部类不能直接访问外部类的私有成员,需要通过实例化外部类来访问。
3.4 非静态内部类可以直接访问外部方法,编译器是怎么做到的?#
非静态内部类可以直接访问外部方法是因为编译器在生成字节码的时候会为非静态内部类维护一个指向外部类实例的引用。 这个引用使得非静态内部类能够访问外部类的实例变量和方法。编译器会在生成非静态内部类的构造方法时,将外部类实例作为参数传入,并在内部类的实例化过程中建立外部类实例与内部类实例之间的联系,从而实现直接访问外部方法的功能。
4. 深拷贝和浅拷贝#
4.1 实现深拷贝的三种方法#
1.实现Cloneable接口并重写clone()方法
这种方法要求对象及其所有引用类型字段都实现Cloneable接口,并且重写clone()方法。在clone()方法中,通过递归克隆引用类型字段来实现深拷贝。
super.clone():调用 Object 类的 clone() 方法,它会进行 浅拷贝,即复制所有字段的值,包括引用字段的“地址”。
class MyClass implements Cloneable {
    private String field1;
    private NestedClass nestedObject;

	@Override
	protected Object clone() throws CloneNotSupportedException {
	    MyClass cloned = (MyClass) super.clone(); // 浅拷贝
	    cloned.nestedObject = (NestedClass) nestedObject.clone(); // 深拷贝
	    return cloned;
	}
}
class NestedClass implements Cloneable {
    private int nestedField;
    @Override
    protected Object clone() throws CloneNotSupportedException {
        return super.clone();
    }
}2.使用序列化和反序列化
3.手动递归复制
5. 泛型#
泛型是 Java 编程语言中的一个重要特性,它允许类、接口和方法在定义时使用一个或多个类型参数,这些类型参数在使用时可以被指定为具体的类型。
public class Demo {
    private static <T extends Number> double add(T a, T b) {
        System.out.println(a + "+" + b + "=" + (a.doubleValue() + b.doubleValue()));
        return a.doubleValue() + b.doubleValue();
    }

    public static void main(String[] args) {
        add(3, 5);         // 输出: 3+5=8.0
        add(2.5, 4.1);     // 输出: 2.5+4.1=6.6
        add(3L, 7L);       // 输出: 3+7=10.0
    }
}<T extends Number>
使用泛型 T,并限制 T 必须是 Number 类或其子类(例如 Integer、Double、Float、Long 等)。
double add(T a, T b)
限制返回值类型为Double
5. 反射#
5.1 反射基础#
通常情况下,我们写的代码在编译时类型就已经确定了,要调用哪个方法、访问哪个字段都是明确的。但反射允许我们在运行时才去探知一个类有哪些方法、哪些属性、它的构造函数是怎样的,甚至可以动态地创建对象、调用方法或修改属性,哪怕这些方法或属性是私有的。
反射具有以下特性:
- 运动时类信息访问: 反射机制允许程序在运行时获取类的完整结构信息,包括类名,包名,父类,方法和字段等。
- 动态对象创建: 可以使用反射API动态地创建对象实例,即使在编译时不知道具体的类名。这是通过Class类的
newInstance()方法或Constructor对象的newInstance()方法实现的 - 动态方法调用: 可以在运行时动态地调用对象的方法,包括私有方法。这通过Method类的
invoke()方法实现,允许你传入对象实例和参数值来执行方法 - 访问和修改字段名: 反射还允许程序在运行时访问和修改对象的字段值,即使是私有的。这是通过Field类的
get()和set()方法完成的。
5.2 Class类#
- Class本身也是一个类
- Class对象只能由系统创建对象
- 一个加载的类在JVM中只有一个Class实例
- 一个Class对象对应的是一个加载到JVM中的一个.class文件
- 每个类的实例都会记得自己是由哪个Class实例所生成
- 通过Class可以完整地得到 一个类中的所有被加载的结构
- Class类是Reflection的根源,针对任何你想动态加载,运行的类,唯有先获得对应的Class对象
5.2.1 Class类对象的获取#
如果我们动态获取到这些信息,我们需要依靠 Class 对象。Class 类对象将一个类的方法、变量等信息告诉运行的程序。Java 提供了四种方式获取 Class 对象:
1. 知道具体类的情况下可以使用:
Class alunbarClass = TargetObject.class;但是我们一般是不知道具体类的,基本都是通过遍历包下面的类来获取 Class 对象,通过此方式获取 Class 对象不会进行初始化
2. 通过 Class.forName()传入类的全路径获取:
Class alunbarClass1 = Class.forName("cn.javaguide.TargetObject");3. 通过对象实例instance.getClass()获取:
TargetObject o = new TargetObject();
Class alunbarClass2 = o.getClass();4. 通过类加载器xxxClassLoader.loadClass()传入类路径获取:
ClassLoader.getSystemClassLoader().loadClass("cn.javaguide.TargetObject");通过类加载器获取 Class 对象不会进行初始化,意味着不进行包括初始化等一系列步骤,静态代码块和静态对象不会得到执行
5.3 反射应用场景#
1.依赖注入与控制反转(IoC)
以 Spring/Spring Boot 为代表的 IoC 框架,会在启动时扫描带有特定注解(如 @Component, @Service, @Repository, @Controller)的类,利用反射实例化对象(Bean),并通过反射注入依赖(如 @Autowired、构造器注入等)。
2.注解处理
注解本身只是个“标记”,得有人去读这个标记才知道要做什么。反射就是那个“读取器”。框架通过反射检查类、方法、字段上有没有特定的注解,然后根据注解信息执行相应的逻辑。比如,看到 @Value,就用反射读取注解内容,去配置文件找对应的值,再用反射把值设置给字段。
3.动态代理与 AOP
想在调用某个方法前后自动加点料(比如打日志、开事务、做权限检查)?AOP(面向切面编程)就是干这个的,而动态代理是实现 AOP 的常用手段。JDK 自带的动态代理(Proxy 和 InvocationHandler)就离不开反射。代理对象在内部调用真实对象的方法时,就是通过反射的 Method.invoke 来完成的。
public class DebugInvocationHandler implements InvocationHandler {
    private final Object target; // 真实对象

    public DebugInvocationHandler(Object target) { this.target = target; }

    // proxy: 代理对象, method: 被调用的方法, args: 方法参数
    public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
        System.out.println("切面逻辑:调用方法 " + method.getName() + " 之前");
        // 通过反射调用真实对象的同名方法
        Object result = method.invoke(target, args);
        System.out.println("切面逻辑:调用方法 " + method.getName() + " 之后");
        return result;
    }
}4.对象关系映射(ORM) 像 MyBatis、Hibernate 这种框架,能帮你把数据库查出来的一行行数据,自动变成一个个 Java 对象。它是怎么知道数据库字段对应哪个 Java 属性的?还是靠反射。它通过反射获取 Java 类的属性列表,然后把查询结果按名字或配置对应起来,再用反射调用 setter 或直接修改字段值。反过来,保存对象到数据库时,也是用反射读取属性值来拼 SQL。
反射举例——输出任意对象数据#
public  void printObject(Object obj) throws IllegalAccessException {
    Class clazz = obj.getClass();
    Field[] fields = clazz.getDeclaredFields();
    for (Field field : fields) {
        field.setAccessible(true);
        String name = field.getName();
        Object value = field.get(obj);
        System.out.println(name + " = " + value);
    }
}6. 注解#
什么是注解?
- 注解(Annotation)在 JVM 层面其实是一种特殊的“标记接口”实现
- 定义在class文件的元数据区域(类似class、method的属性表),由编译器生成字节码
- 若注解使用
@Retention(RetentionPolicy.RUNTIME),则它会被编译进 class 文件,并且在运行时可通过反射读取 - 在代理逻辑里,利用 反射读取注解,决定如何增强目标方法
6.1 注解举例#
注解本质是一个继承了Annotation的特殊接口,其具体实现类是Java运行时生成的动态代理类。 我们通过反射获取注解时,返回的是Java运行时生成的动态代理对象。通过代理对象调用自定义注解的方法,会最终调用AnnotationInvocationHandler的invoke方法。该方法会从memberValues这个Map中索引出对应的值。而memberValues的来源是Java常量池。
6.2 注解的底层实现#
注解本质上是一种特殊的接口,它继承于java.lang.annotation.Annotation接口,所以注解也叫做声明式接口,定义一个简单的接口:
@Retention(RetentionPolicy.RUNTIME)
@Target(ElementType.FIELD)
public @interface JsonField {
	public String value() default "";
}编译后,Java 编译器会将其转换为一个继承自 Annotation 的接口,并生成相应的字节码文件。
根据注解的作用范围,Java 注解可以分为以下几种类型:
- 源码级别注解 :仅存在于源码中,编译后不会保留
@Retention(RetentionPolicy.SOURCE)。 - 类文件级别注解 :保留在 .class 文件中,但运行时不可见
@Retention(RetentionPolicy.CLASS)。 - 运行时注解 :保留在 .class 文件中,并且可以通过反射在运行时访问
@Retention(RetentionPolicy.RUNTIME)。
只有运行时注解可以通过反射机制进行解析。 当注解被标记为 RUNTIME 时,Java 编译器会在生成的 .class 文件中保存注解信息。这些信息存储在字节码的属性表(Attribute Table)中,具体包括以下内容:
- RuntimeVisibleAnnotations :存储运行时可见的注解信息。
- RuntimeInvisibleAnnotations :存储运行时不可见的注解信息。
- RuntimeVisibleParameterAnnotations 和 RuntimeInvisibleParameterAnnotations :存储方法参数上的注解信息。
通过工具(如
javap -v)可以查看.class文件中的注解信息。
注解的解析主要依赖于Java的反射机制。以下是解析注解的基本流程:
- 获取注册信息:通过反射API可以获取类,方法,字段等元素上的注解
Class<?> clazz = MyClass.class;
MyAnnotation annotation = clazz.getAnnotation(MyAnnotation.class);
if (annotation != null) {
	System.out.println(annotation.value());
}- 底层原理:反射机制的核心类是
java.lang.reflect.AnnotatedElement,它是所有可以被注解修饰的元素(如Class,Method,Field等)的父接口,该接口提供了以下方法:
getAnnotation(Class<T> annotationClass):获取指定类型的注解。getAnnotations():获取所有注解。isAnnotationPresent(Class<? extends Annotation> annotationClass):判断是否包含指定注解。
JVM在加载类时会解析.class文件中的注解信息,并将其存储在内存中,供反射机制使用。
因此,注解解析的底层实现主要依赖于Java的反射机制和字节码文件的存储。通过@Retention元注解可以控制注解的保留策略,当使用 RetentionPolicy.RUNTIME 时,可以在运行时通过反射 API 来解析注解信息。在 JVM 层面,会从字节码文件中读取注解信息,并创建注解的代理对象来获取注解的属性值。
7. 异常#
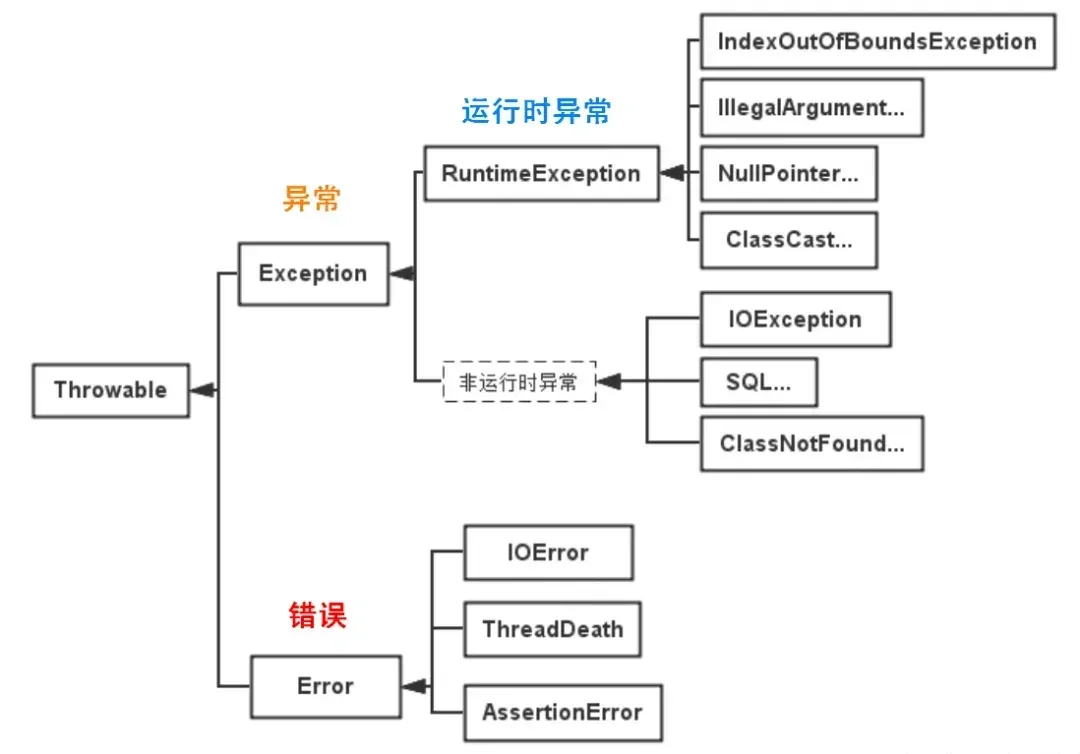
finally块中的return语句会覆盖try块中的return返回,因此该语句会返回’b’
try{
	return 'a';
}finally{
	return 'b';
}8. Java8的一些特性#
8.1 Lambda表达式#
Lambda表达式用于创建匿名函数,主要用于简化函数式接口(只有一个抽象方法的接口)的使用,基本语法有两种形式:
(parameters) -> expression:当Lambda体只有一个表达式时使用,表达式的结果会作为返回值。(parameters) -> { statements; }:当 Lambda 体包含多条语句时,需要使用大括号将语句括起来,若有返回值则需要使用 return 语句。
9. I/O#
9.1 Java NIO#
Java NIO,是一种同步非阻塞的I/O模型,也是I/O多路复用的基础
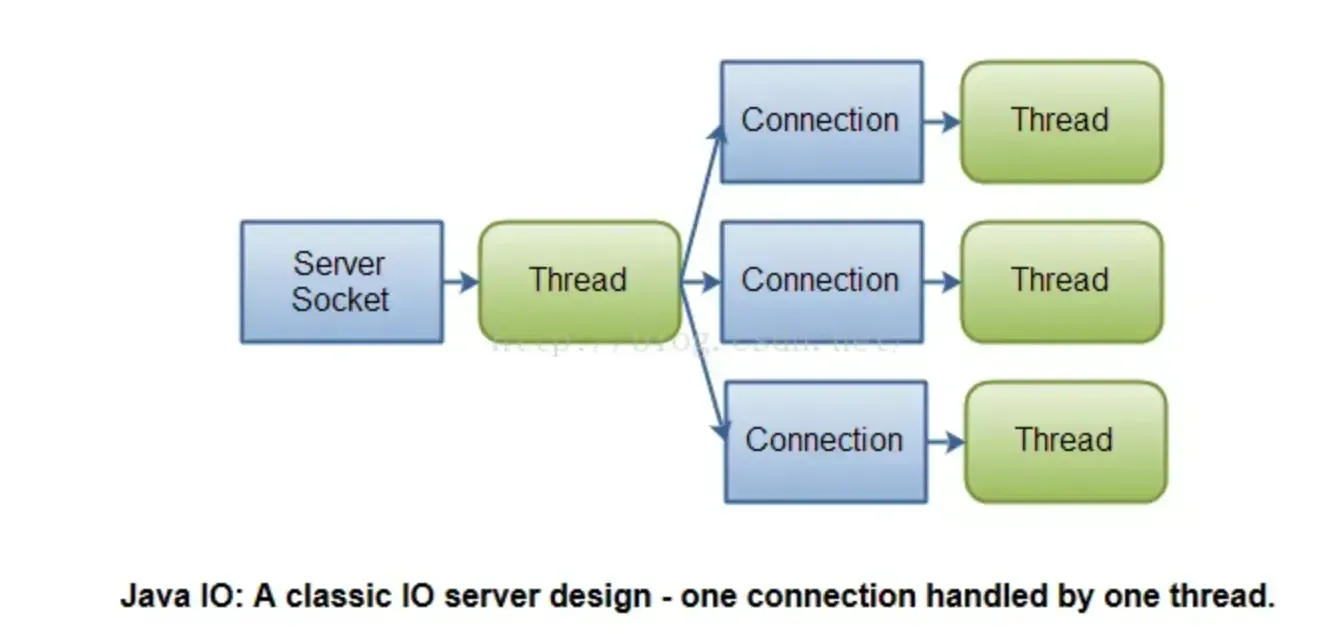
传统的BIO里socket.read(),如果TCP RecvBuffer里没有数据,函数会一直阻塞,直到收到数据,返回读到的数据,如果使用BIO想要并发处理多个客户端的I/O,那么会使用多线程模式,一个线程专门处理一个客户端io,这种模式随着客户端越来越多,所需要创建的线程也越来越多,会急剧消耗系统的性能。
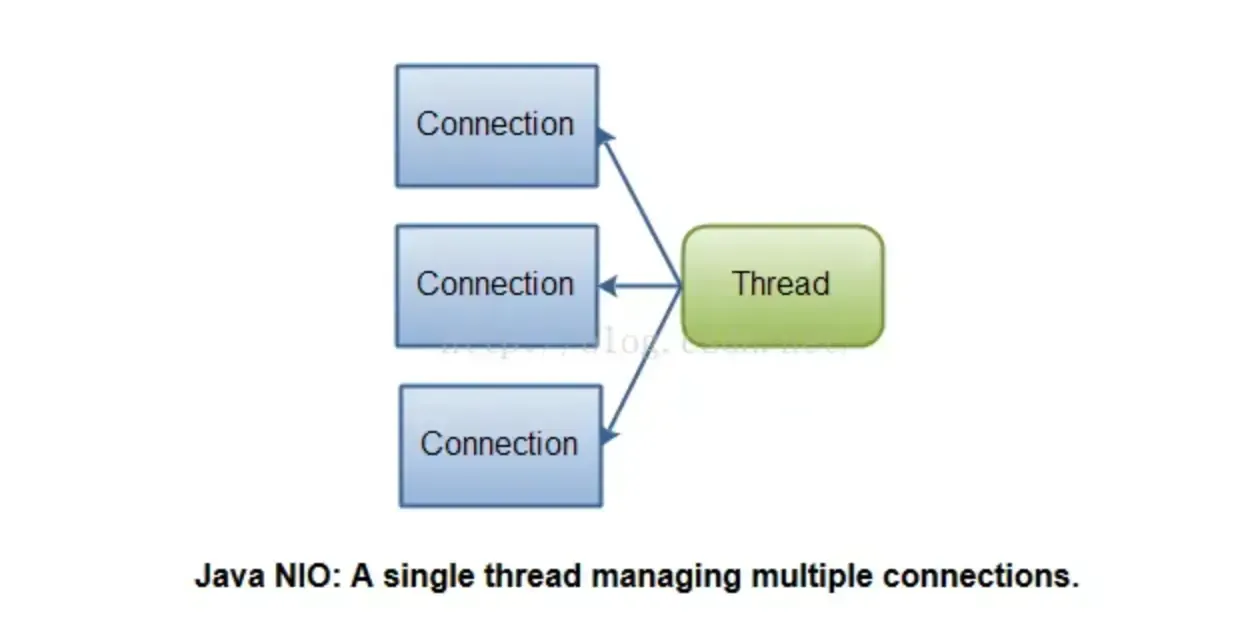
NIO 是基于I/O多路复用实现的,它可以只用一
个线程处理多个客户端I/O,如果你需要同时管理成千上万的连接,但是每个连接只发送少量数据,例如一个聊天服务器,用NIO实现会更好一些。
9.2 NIO是怎么实现的#
NIO是一种同步非阻塞的IO模型,所以也可以叫NON-BLOCKINGIO。同步是指线程不断轮询IO事件是否就绪,非阻塞是指线程在等待IO的时候,可以同时做其他任务。
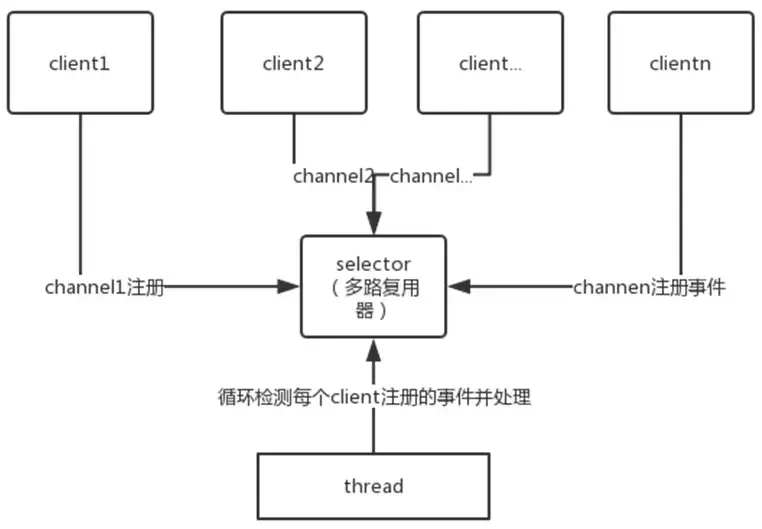
同步的核心就Selector(I/O多路复用),Selector代替了线程本身轮询IO事件,避免了阻塞同时减少了不必要的线程消耗;非阻塞的核心就是通道和缓冲区,当IO事件就绪时,可以通过写到缓冲区,保证IO的成功,而无需线程阻塞式地等待。
NIO由一个专门的线程处理所有IO事件,并负责分发。事件驱动机制,事件到来的时候触发操作,不需要阻塞的监视事件。线程之间通过wait,notify通信,减少线程切换。
NIO主要有三大核心部分:Channel(通道),Buffer(缓冲区), Selector。传统IO基于字节流和字符流进行操作,而NIO基于Channel和Buffer(缓冲区)进行操作,数据总是从通道读取到缓冲区中,或者从缓冲区写入到通道中。
Selector(选择区)用于监听多个通道的事件(比如:连接打开,数据到达)。因此,单个线程可以监听多个数据通道。
Java值传递#
- 值传递:方法接收的是实参值的拷贝,会创建副本。
- 引用传递:方法接收的直接是实参所引用的对象在堆中的地址,不会创建副本,对形参的修改将影响到实参。 很多程序设计语言(比如 C++、 Pascal)提供了两种参数传递的方式,不过,在 Java 中只有值传递。
为什么Java只有值传递#
传递基本类型参数#
public static void main(String[] args) {
    int num1 = 10;
    int num2 = 20;
    swap(num1, num2);
    System.out.println("num1 = " + num1);
    System.out.println("num2 = " + num2);
}

public static void swap(int a, int b) {
    int temp = a;
    a = b;
    b = temp;
    System.out.println("a = " + a);
    System.out.println("b = " + b);
}输出:
a = 20
b = 10
num1 = 10
num2 = 20传递引用类型参数#
  public static void main(String[] args) {
      int[] arr = { 1, 2, 3, 4, 5 };
      System.out.println(arr[0]);
      change(arr);
      System.out.println(arr[0]);
  }

  public static void change(int[] array) {
      // 将数组的第一个元素变为0
      array[0] = 0;
}输出:
1
0为了这个案例很多人肯定觉得 Java 对引用类型的参数采用的是引用传递。
实际上,并不是的,这里传递的还是值,不过,这个值是实参的地址罢了!
也就是说 change 方法的参数拷贝的是 arr (实参)的地址,因此,它和 arr 指向的是同一个数组对象。这也就说明了为什么方法内部对形参的修改会影响到实参。
为了更强有力地反驳 Java 对引用类型的参数采用的不是引用传递,我们再来看下面这个案例!
传递引用类型参数2#
public class Person {
    private String name;
   // 省略构造函数、Getter&Setter方法
}

public static void main(String[] args) {
    Person xiaoZhang = new Person("小张");
    Person xiaoLi = new Person("小李");
    swap(xiaoZhang, xiaoLi);
    System.out.println("xiaoZhang:" + xiaoZhang.getName());
    System.out.println("xiaoLi:" + xiaoLi.getName());
}

public static void swap(Person person1, Person person2) {
    Person temp = person1;
    person1 = person2;
    person2 = temp;
    System.out.println("person1:" + person1.getName());
    System.out.println("person2:" + person2.getName());
}输出:
person1:小李
person2:小张
xiaoZhang:小张
xiaoLi:小李解析:
怎么回事???两个引用类型的形参互换并没有影响实参啊!
swap 方法的参数 person1 和 person2 只是拷贝的实参 xiaoZhang 和 xiaoLi 的地址。因此, person1 和 person2 的互换只是拷贝的两个地址的互换罢了,并不会影响到实参 xiaoZhang 和 xiaoLi 。
总结#
Java 中将实参传递给方法(或函数)的方式是 值传递:
- 如果参数是基本类型的话,很简单,传递的就是基本类型的字面量值的拷贝,会创建副本。
- 如果参数是引用类型,传递的就是实参所引用的对象在堆中地址值的拷贝,同样也会创建副本。